تفرع Pearl FP8: كيف ينتقل تعدين PRL إلى النقطة العائمة ومن يبقى على الشبكة
7/10/2026
تم التحديث في 7 أكتوبر 2026. لم يتم تحديد تاريخ أو كتلة للتفعيل للتفرع.
يدعم تجمع Kryptex كل تفرعات Pearl، بما في ذلك المستقبلية، للحفاظ على أمان واستقرار الشبكة. يمكنك متابعة أخبار التفرع على موقعنا: pool.kryptex.com.
⚡ ملخص سريع
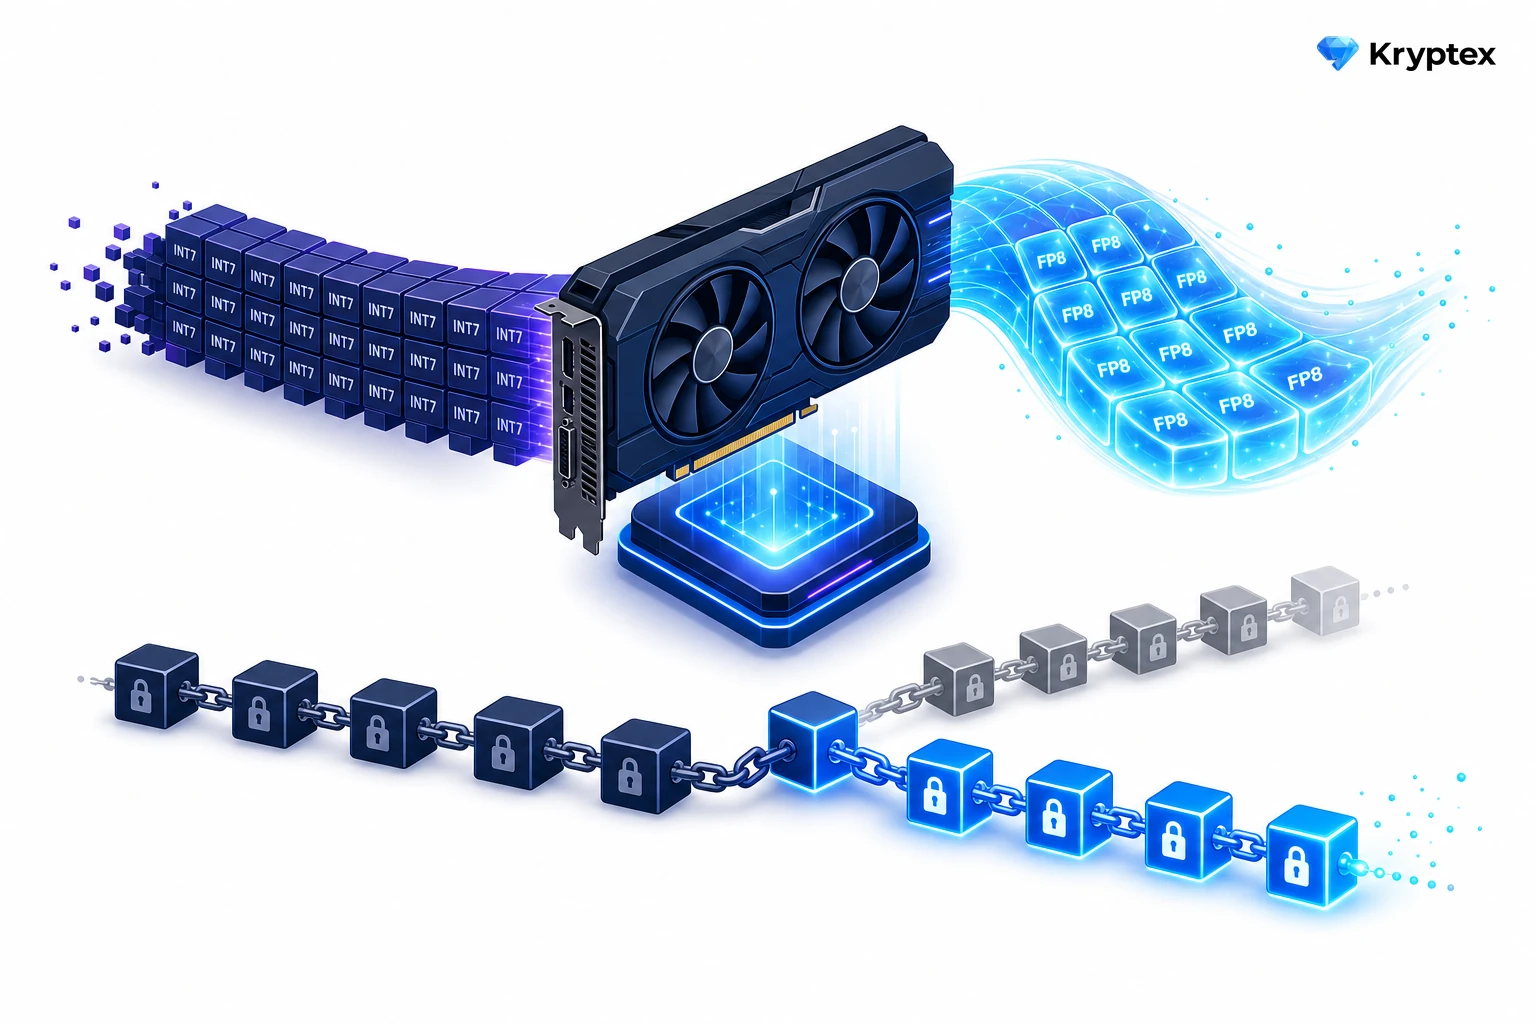
- تستعد Pearl (PRL) لتفرع hard fork: ينتقل التعدين من الأعداد الصحيحة،
INT7 × INT7 → INT32، إلى النقطة العائمة،FP8 × FP8 → FP32. المواصفات هي PIP-3، الحالة: مسودة. - لن تقبل العقد القديمة الشهادات الجديدة، لذا يجب على كل عقدة الترقية.
- تحدد شهادة PIP-3 نوعين من الأجهزة: NVIDIA Hopper وNVIDIA Blackwell. لا توجد Ampere (سلسلة RTX 30)، Turing (سلسلة RTX 20)، Ada (سلسلة RTX 40)، وAMD في المواصفات.
- في جلسة AMA في 15 سبتمبر، أكد المؤسسون أن RTX 5090 وRTX PRO 6000 Blackwell سيستمرون في التعدين بعد تفرع FP8.
- لم يتم تحديد تاريخ: ستقوم الفريق بترقية الشبكة بمجرد أن تكون واثقة من أمان التنفيذ. سيأتي FP4 لاحقًا، جنبًا إلى جنب مع FP8، وليس بدلاً منه.
🧠 تعدين يحسب الشبكات العصبية
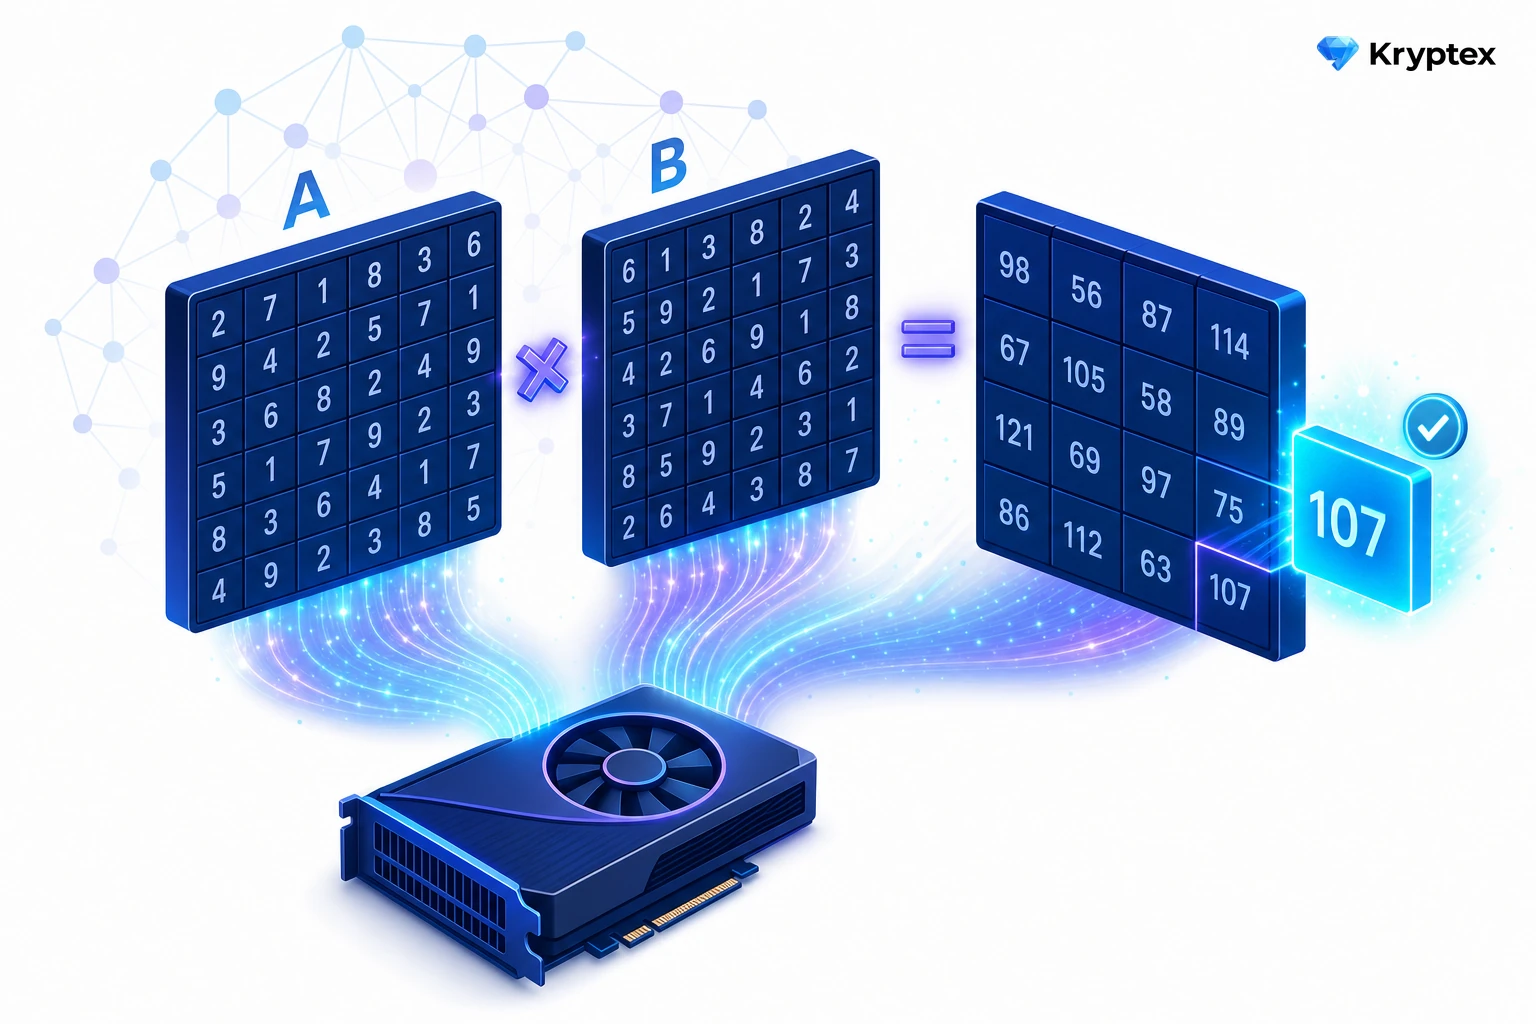
Pearl هي بلوكشين حيث لا تقوم وحدة GPU بطحن hashes بل تقوم بنفس العمليات الرياضية التي تستخدمها لتشغيل نموذج ذكاء اصطناعي، مثل روبوت الدردشة. في التعدين العادي، تحتاج الشبكة فقط إلى النتيجة. في Pearl، تضاعف وحدة GPU جداول كبيرة من الأرقام (مصفوفات)، وتلك المضاعفة هي إثبات العمل.
يحتوي كل نموذج ذكاء اصطناعي على مجموعة ضخمة من هذه الجداول، تسمى الأوزان. للإجابة على سؤالك، يقوم النموذج بضرب بياناتك بها مرارًا وتكرارًا. لهذا السبب يحتاج الذكاء الاصطناعي إلى وحدات GPU قوية، ولماذا اختارت Pearl هذه العملية.
إليك كيف يعمل. يأخذ المعدّن أوزان النموذج والبيانات المدخلة، أو يبني الجداول بنفسه عندما لا يكون هناك عمل ذكاء اصطناعي حقيقي متاح. لمنع أي شخص من إرسال قشرة فارغة، يخلط البروتوكول "الضوضاء" في الجداول ويطرحها بعد المضاعفة. يتم تقسيم النتيجة إلى قطع صغيرة تسمى البلاطات. إذا كان hash البلاطة أقل من الهدف، فقد وجد المعدّن حصة. تذهب الحصص إلى شهادة تتحقق منها الشبكة.
➗ الأعداد الصحيحة والكسور
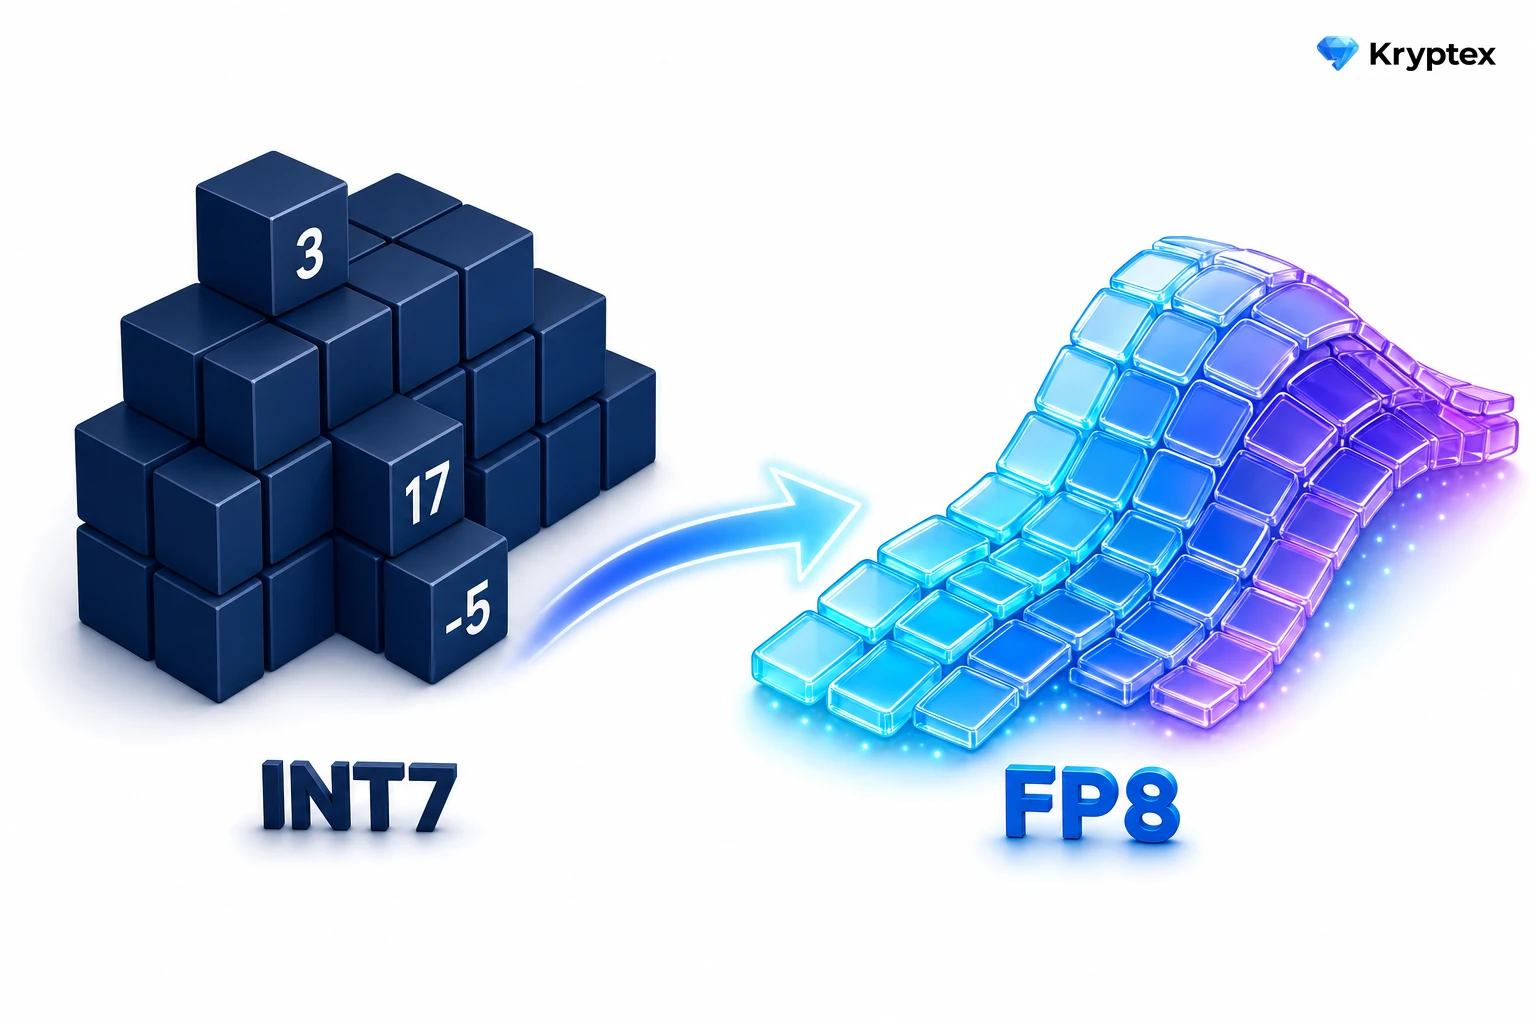
اليوم تقوم Pearl بالحساب بالأعداد الصحيحة (INT)، أو الأعداد الكاملة: 3، 17، −5. يُسمى التنسيق INT7، ويتم الاحتفاظ بالمجموع الجاري في INT32. تحافظ الأعداد الكاملة على الأمور بسيطة: تعطي كل وحدة GPU نفس الإجابة حتى آخر بت، لذا يمكن للشبكة التحقق من نتيجة أي شخص.
لكن أوزان نموذج الذكاء الاصطناعي تُخزن ككسور، مثل 0.0003 أو 150.25. يُعرف هذا التنسيق بالنقطة العائمة (FP). للتعدين بالأعداد الصحيحة، يقوم المعدّن بتقريب أوزان النموذج إلى INT7، وهي خطوة تُسمى التكميم. FP8 هو طريقة مضغوطة لكتابة عدد كسري في 8 بتات فقط. بعد التفرع، يقوم المعدّن بالحساب بتنسيق أقرب إلى التنسيق الذي تستخدمه نماذج الذكاء الاصطناعي نفسها.
🔬 ما الذي يغيره PIP-3
يعمل النظام الجديد في PIP-3 كالتالي:
- تصل جداول الإدخال في BF16 وتُحول إلى FP8 (E4M3) صفًا بصف قبل المضاعفة. يتم كتابة مقياس كل صف في الشهادة.
- الضوضاء أيضًا FP8. يولدها BLAKE3 من hashes الجداول، لذا لا يمكن للمعدّن اختيار الضوضاء.
- تُضرب الأرقام في FP8، ويتم الاحتفاظ بالمجموع الجاري في FP32 الأكثر دقة.
- تحتوي الشهادة على حقل
device:0لـ Hopper،1لـ Blackwell.
مع الكسور، تعتمد الإجابة على وحدة GPU: تقوم الرقائق المختلفة بالتقريب بشكل مختلف، لذا تنحرف النتائج قليلاً. يرفض مؤلفو PIP-3 أي تسامح مع هذا الانحراف: سيسمح ذلك للمعدّن بتوجيه الإجابة للحصول على المزيد من الفرص للعثور على حصة دون حساب إضافي (هجوم طحن). لذا لا تتسامح الشبكة مع أي اختلاف. يكتب المواصفات قواعد التقريب الدقيقة لكل نوع من وحدات GPU، ويتم التحقق من كل إجابة وفقًا لها. هذا هو مصدر القائمة البيضاء: فقط أنواع الأجهزة التي تحتوي على قواعد مكتوبة تدخل في الشهادة.
🎯 لماذا التفرع
يقدم مؤلفو PIP-3 سببين. أولاً، تعمل نماذج الذكاء الاصطناعي بشكل طبيعي مع الكسور، والتقريب إلى الأعداد الصحيحة موجود فقط للتعدين. ثانيًا، يعمل التعدين والعمل المفيد للذكاء الاصطناعي على نفس العملية، لذا فإن التكلفة الإضافية صغيرة. وفقًا لحسابات المؤسسين (AMA)، فإن التكلفة الإضافية تتراوح بين 5-7% لكل مضاعفة جدول وأقل عبر تشغيل النموذج بالكامل، وتكون فعليًا صفرًا في بعض الاختبارات. هذه تقديرات الفريق الخاصة، وليست معايير مستقلة.
الثمن هو القفل على وحدات GPU محددة: يصف PIP-3 هذا الاعتماد بأنه لا مفر منه للنقطة العائمة.
FP4، وهو تنسيق مضغوط أكثر بـ 4 بتات، ليس جزءًا من هذا التفرع. سيتم إضافته جنبًا إلى جنب مع FP8؛ قدر المطور بضعة أشهر إضافية من العمل لكنه لم يعطِ تاريخ إصدار.
🎮 من يبقى على الشبكة
تفرق شهادة PIP-3 بين نوعين من الأجهزة. التجميع للبطاقات الأخرى أدناه هو استنتاجنا من قدرات الرقائق (قائمة NVIDIA Compute Capability).
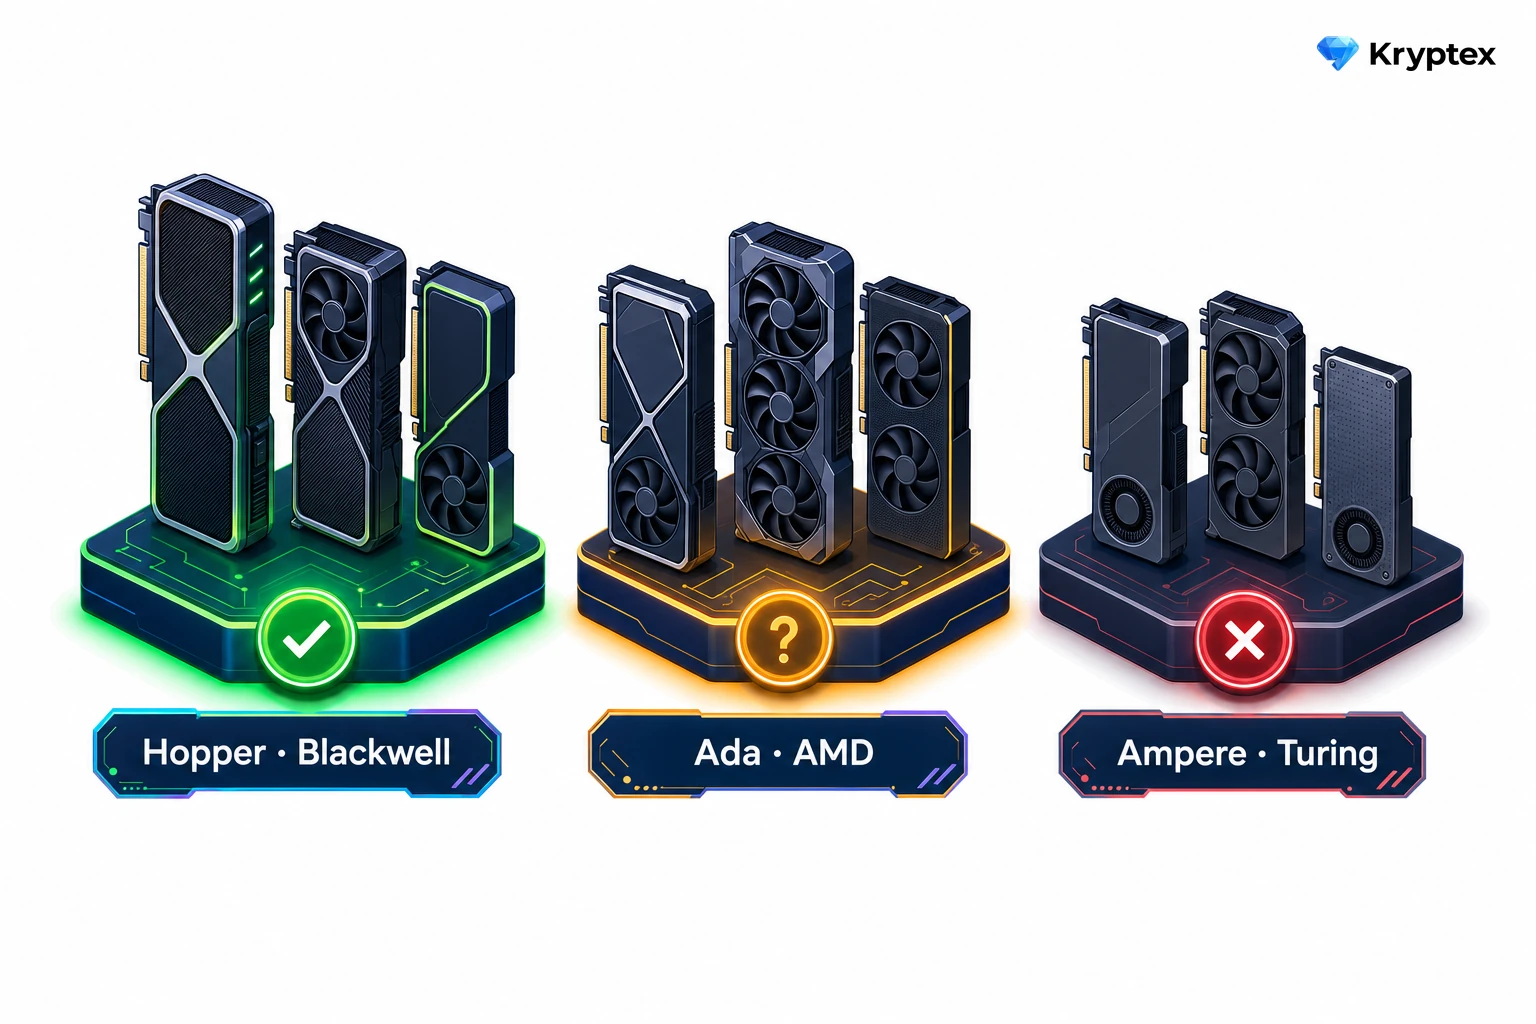
🟢 Hopper وBlackwell: مدمجة في البروتوكول. في AMA، أكد المؤسسون أن RTX 5090 وRTX PRO 6000 Blackwell سيعملان بعد التفرع وسيدعمان ترقية FP4 المستقبلية. فات Hopper (H100) الإصدار الأول من الكود بسبب كيفية تعامله مع بعض العمليات ذات 32 بت؛ تم دعمها في 27 سبتمبر 2026 (PR #337). لا تقدم PIP-3 ولا AMA قائمة توافق كاملة، لذا سيحدد إصدار العقدة المجموعة الدقيقة.
🟡 Ada وAMD: FP8 في الأجهزة، وليس في البروتوكول. يمكن لبطاقات Ada Lovelace (سلسلة RTX 40، L4، L40، L40S) وبطاقات AMD مع FP8 في الأجهزة (MI300، MI350، RDNA4) الحساب في FP8، لكن PIP-3 لا يحتوي على ملف تعريف لها. في AMA، قال المؤسسون إنهم على المدى الطويل يريدون التخلص من وحدات GPU القديمة جدًا التي لا يمكنها التعامل مع أحمال العمل بالنقطة العائمة، لكنهم لم يعطوا جدولًا زمنيًا أو قائمة استبعاد كاملة.
🔴 Ampere، Turing، وAMD الأقدم: لا يوجد FP8 في الأجهزة. يشمل ذلك سلسلة RTX 30 وسلسلة RTX 20، وA100، وبطاقات التعدين CMP 170HX وCMP 90HX، وسلسلة RX 6000 وRX 7000 من AMD.
يقترح أعضاء المجتمع حلولًا بديلة، مثل وضع FP16 لـ A100 (PR #369). هذه مبادرات من المساهمين، وليست قرارات الشبكة.
📅 متى سيحدث التفرع
لا يوجد تاريخ. لا يزال PIP-3 مسودة، ولا يحدد ارتفاع التفعيل. في AMA، قال المؤسسون إنهم سيقومون بترقية الشبكة بمجرد أن يكونوا واثقين من التنفيذ وأمانه. إذا بقيت الشكوك، فلن يكون هناك تفرع.
✅ ما الذي يجب أن يفعله المعدّنون
- Hopper وBlackwell: يفتح التفرع التعدين FP8 لهم. تابع إصدارات العقدة والمعدّن التي تدعم الشهادة الجديدة.
- سلسلة RTX 40، 30، و20، بطاقات CMP، وبطاقات AMD: يستمر التعدين كالمعتاد حتى التفرع. بعد التفعيل، وفقًا لـ PIP-3 الحالي، لا يمكن لهذه البطاقات إنتاج شهادات صالحة. ضع هذا الخطر في حسابات استردادك.
- في وقت التفرع، قم بتحديث المعدّن الخاص بك إلى إصدار يدعم البروتوكول الجديد.
- أين تتابع: تجمع Kryptex، مستودع PIP، وإصدارات Pearl.
⛏ كيف تعدين PRL الآن
حتى التفرع، يتم تعدين PRL كالمعتاد. لبدء التعدين على تجمع Kryptex، تحتاج إلى ثلاث خطوات:
- محفظة. أنشئ عنوان PRL باستخدام هذا الدليل.
- معدّن. اختر معدّنًا في نظرة عامة على معدّني Pearl.
- الاتصال. أدخل عنوان محفظتك واسم العامل على صفحة تجمع PRL، ثم ابدأ المعدّن بعنوان الخادم
prl.kryptex.network:7048.
للحصول على شرح كامل، انظر كيفية تعدين Pearl (PRL).
❓ الأسئلة الشائعة
هل ستقوم RTX 5090 وRTX PRO 6000 Blackwell بالتعدين؟ نعم. أكد المؤسسون كلا البطاقتين في AMA.
هل ستقوم RTX 4090 بالتعدين بعد التفرع؟ ليس وفقًا لـ PIP-3 الحالي: الشهادة تقبل فقط Hopper وBlackwell. لم يعلق المؤسسون على 4090 بشكل محدد.
هل ستقوم RTX 3090 وبطاقات RTX 30 الأخرى بالتعدين؟ لا، بناءً على المواصفات الحالية: هذه الرقائق لا تحتوي على FP8 في الأجهزة، وPIP-3 لا يسرد أي ملف تعريف لـ Ampere.
متى يكون التفرع؟ لم يتم تحديد تاريخ أو كتلة للتفعيل.
هل يدعم تجمع Kryptex تفرع FP8؟ نعم. نحن ندعم كل تفرعات Pearl، بما في ذلك المستقبلية، للحفاظ على أمان واستقرار الشبكة. تابع أخبار التفرع على pool.kryptex.com.
هل تحتاج إلى مساعدة؟
هل لديك أي أسئلة، شيء غير واضح، أو مشكلة في الاتصال؟
اتصل بالدعم — نحن سعداء بمساعدتك!
- تذكرة دعم.
- دعم تيليجرام.
- دعم ديسكورد.
- دعم البريد الإلكتروني على support@kryptex.com.